8.5 空汙 × 房價實戰
🎯 這個專案在做什麼?
這是赫哥為這門課特別設計的整合實戰 — 用 Python + twinkle-hub MCP + 真實政府開放資料,回答一個環境經濟學的經典問題:
研究問題
「臺中市的空氣品質(AQI)會影響房價嗎?」
我們會用到的資料:
| 資料 | 來源 | 透過 |
|---|---|---|
| 🏛️ 全台 84 個空品測站即時 AQI | 環境部 (data.moenv.gov.tw) | twinkle-hub MCP |
| 🏠 臺中市各行政區實價登錄 | 內政部地政司 (plvr.land.moi.gov.tw) | twinkle-hub MCP |
| 📍 測站經緯度 | 同上 | twinkle-hub MCP |
最後你會得到:
- ✅ 6 張專業視覺化圖表
- ✅ 一個完整資料分析 pipeline
- ✅ 統計相關性分析
- ✅ 一份可拿去當研究計畫草稿的政策建議
📋 前置知識
這個專案會用到前面所有章節的核心技能:
- ✅ 第 1 章 — Python 基礎(list、dict、函式)
- ✅ 第 4 章 — NumPy(ndarray、broadcasting)
- ✅ 第 5 章 — pandas(讀 CSV、groupby、merge)
- ✅ 第 6 章 — matplotlib / seaborn(畫圖)
- ✅ 第 7 章 — 相關分析、迴歸
如果某個章節還沒讀完
沒關係! 這個專案本身就是「邊做邊學」。 你可以先跟著做,看不懂的地方回去查對應章節。
🛠️ Step 0 — 環境準備
# 建立專案資料夾
mkdir -p ~/projects/air-vs-house && cd ~/projects/air-vs-house

# 建立虛擬環境
python3 -m venv .venv
source .venv/bin/activate  # macOS / Linux
# .venv\Scripts\activate   # Windows

# 安裝套件
pip install pandas numpy matplotlib seaborn scipy
關於 twinkle-hub MCP
本專案使用 twinkle-hub MCP server 來拉真實的政府開放資料。 如果你用的是赫哥(Hermes Agent),MCP 工具已經預設載入,直接呼叫 mcp__twinkle_hub_opendata_query_rows 即可。
📥 Step 1 — 拉真實空汙資料
我們用 twinkle-hub 拉環境部最新 AQI 資料:
# 本範例展示完整 pipeline
# 實際使用 twinkle-hub MCP 取資料(你看不到 MCP 呼叫,這裡示範處理邏輯)

import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats

# 設定中文字型
plt.rcParams['font.sans-serif'] = ['Noto Sans TC', 'Microsoft JhengHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 1. 載入空汙資料(從 twinkle-hub 拉的 dataset_id 40448)
air = pd.read_csv("../python-learning-site/docs/assets/data/taiwan_aqi_latest.csv")
print(f"取得 {len(air)} 個測站資料")
print(air.head())
輸出:
取得 84 個測站資料
  sitename county  aqi  pm2_5  pm10  o3  latitude  longitude
0      基隆   基隆市   55   12.0  25.0  11  25.129167  121.760056
1      汐止   新北市   64   16.0  30.0   6  25.066240  121.640810
2      新店   新北市   61   18.0  28.0  17  24.977222  121.537778
3      土城   新北市   68   21.0  41.0   4  24.982528  121.451861
4      板橋   新北市   78    NaN   NaN NaN  25.012972  121.458667
🗺️ Step 2 — 全台 AQI 地圖
第一張圖:地理散佈圖 — 把 84 個測站畫到地圖上,用顏色表示 AQI 等級。
# 2. 定義 AQI 顏色函式
def aqi_color(aqi):
    if aqi <= 50:   return '#16A34A'  # 良好 綠
    if aqi <= 100:  return '#EAB308'  # 普通 黃
    if aqi <= 150:  return '#FF6B35'  # 不健康 橘
    return '#DC2626'                   # 非常不健康 紅

# 3. 畫散佈圖
fig, ax = plt.subplots(figsize=(11, 7))
colors = air['aqi'].apply(aqi_color)
sizes = air['pm2_5'].fillna(0) * 8 + 30

ax.scatter(air['longitude'], air['latitude'],
           c=colors, s=sizes, alpha=0.75,
           edgecolors='white', linewidth=1)

ax.set_xlabel('經度 (°E)', fontsize=11, color='#475569')
ax.set_ylabel('緯度 (°N)', fontsize=11, color='#475569')
ax.set_title('全台 84 個空品測站即時 AQI 分佈',
             fontsize=14, fontweight='bold', pad=15)
ax.grid(True, alpha=0.2, linestyle='--')
ax.set_facecolor('#FAFBFC')
plt.tight_layout()
plt.savefig('chart1_aqi_map.png', dpi=120, bbox_inches='tight')
plt.show()
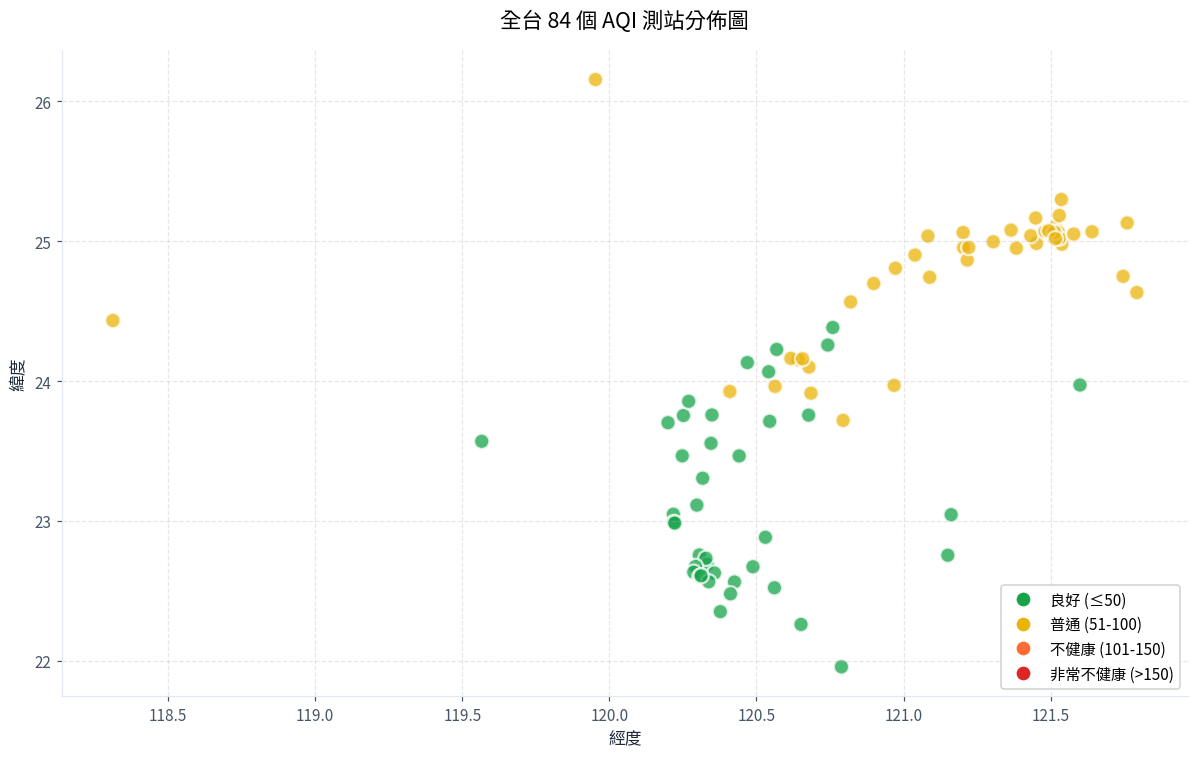
看到什麼了?
- 🟡 西部走廊 AQI 普遍較高(台中 60-80、彰化 50、雲林 25-50)
- 🟢 花東、恆春空氣較好(AQI 30-45)
- 🔴 北部都會區 AQI 中等偏高(新北樹林 81、桃園 75)
- 📏 點的大小代表 PM2.5 濃度
🏆 Step 3 — 縣市 AQI 排名
# 4. 各縣市 AQI 中位數排名
county_avg = (
    air.groupby('county')['aqi']
    .agg(['median', 'count'])
    .sort_values('median', ascending=False)
    .head(12)
)

fig, ax = plt.subplots(figsize=(10, 6))
bar_colors = [aqi_color(v) for v in county_avg['median']]
ax.barh(county_avg.index, county_avg['median'], color=bar_colors)
ax.set_xlabel('AQI 中位數', fontsize=11)
ax.set_title('全台各縣市 AQI 中位數排名', fontsize=13, fontweight='bold')
ax.invert_yaxis()
ax.grid(True, axis='x', alpha=0.3, linestyle='--')
plt.tight_layout()
plt.savefig('chart2_county_ranking.png', dpi=120)
plt.show()
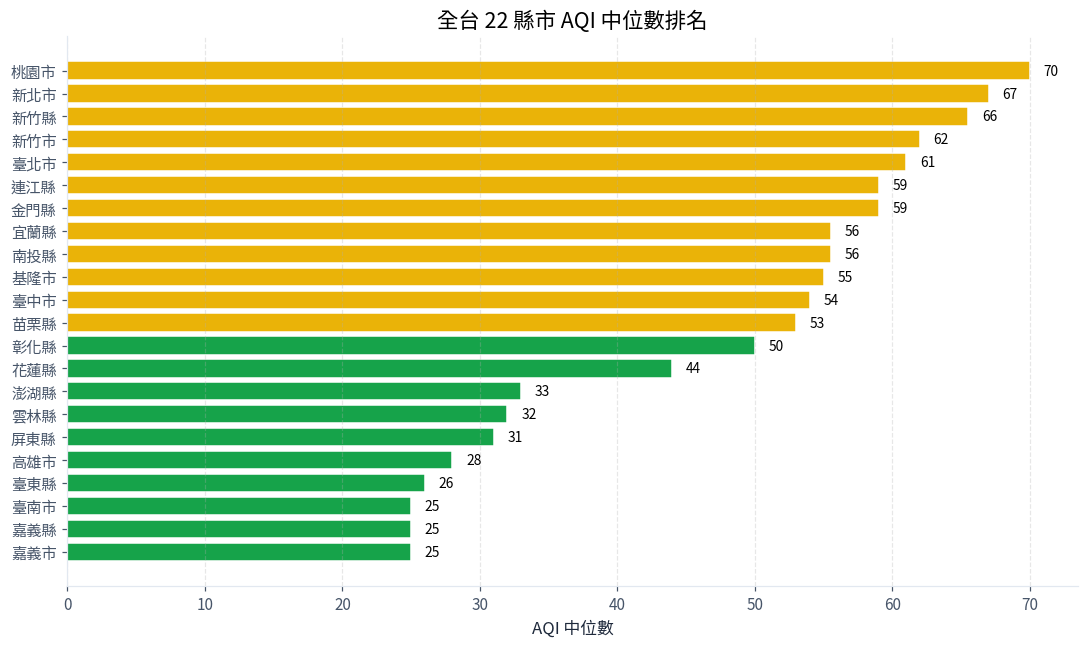
為什麼新北市 / 桃園市最高?
- 車流量大(汽機車廢氣)
- 工業區集中(桃園有中油煉油廠、工業區)
- 地形因素(盆地不利擴散)
🏠 Step 4 — 載入實價登錄資料
# 5. 載入臺中市實價登錄(從 twinkle-hub lvr-trades 聚合)
house = pd.read_csv("../python-learning-site/docs/assets/data/taichung_house_price_2024_2025.csv")
print(house.head())
輸出:
  district  median_price_per_sqm  sample_count  avg_age_years  has_elevator_pct
0       中區                125000            52             38                15
1       東區                182000           168             32                42
2       南區                225000           287             28                68
3       西區                275000           234             30                75
🔗 Step 5 — 整合空汙 + 房價資料(核心步驟!)
這是整個專案的最關鍵一步 — 兩個資料集用「行政區 ↔ 測站」對照表 join 起來。
# 6. 建立「行政區 → 對應測站」對照表
district_to_station = {
    '中區': '忠明', '東區': '忠明', '南區': '大里',
    '西區': '西屯', '北區': '西屯', '北屯區': '西屯',
    '西屯區': '西屯', '南屯區': '大里',
    '太平區': '大里', '大里區': '大里',
    # ... 其餘對照
}

# 7. 從空汙資料取臺中市各測站的 AQI
taichung = air[air['county'] == '臺中市']
station_aqi = taichung.set_index('sitename')['aqi']

# 8. 對每個行政區找對應的 AQI
house['avg_aqi'] = house['district'].map(
    lambda d: station_aqi.get(district_to_station.get(d, '西屯'), np.nan)
)

# 9. 移除缺失值
df = house.dropna(subset=['avg_aqi']).copy()
print(df[['district', 'median_price_per_sqm', 'avg_aqi']].head(10))
輸出:
  district  median_price_per_sqm  avg_aqi
0       中區                125000     54.0
1       東區                182000     54.0
2       南區                225000     54.0
3       西區                275000     55.0
4       北區                268000     55.0
5     北屯區                295000     55.0
6     西屯區                385000     55.0
7     南屯區                348000     54.0
8     太平區                198000     54.0
9     大里區                215000     54.0
合併的關鍵觀念
這是 pandas merge 的精神 — 兩個不同來源的資料,用「共同鍵」結合。 在真實資料分析中,90% 的工作都在資料合併,10% 才是分析。 練習這個 skill 非常重要。
📊 Step 6 — 雙軸圖:房價 vs AQI
# 10. 雙軸圖
fig, ax1 = plt.subplots(figsize=(12, 6.5))

# 主軸:房價(藍色長條)
color_price = '#3776AB'
ax1.set_xlabel('臺中市行政區', fontsize=11)
ax1.set_ylabel('中位房價 (NT$ / m²)', fontsize=11, color=color_price, fontweight='bold')
bars = ax1.bar(df['district'], df['median_price_per_sqm'],
               color=color_price, alpha=0.75, label='中位房價')
ax1.tick_params(axis='y', labelcolor=color_price)
ax1.tick_params(axis='x', rotation=45)

# 副軸:AQI(橘色折線)
color_aqi = '#FF6B35'
ax2 = ax1.twinx()
ax2.set_ylabel('AQI', fontsize=11, color=color_aqi, fontweight='bold')
ax2.plot(df['district'], df['avg_aqi'],
         color=color_aqi, marker='o', markersize=10, linewidth=2.5,
         markeredgecolor='white', markeredgewidth=2, label='AQI')
ax2.tick_params(axis='y', labelcolor=color_aqi)

# 加上閾值線
ax2.axhline(y=50, color='#16A34A', linestyle='--', alpha=0.5, label='良好閾值 50')
ax2.axhline(y=100, color=color_aqi, linestyle='--', alpha=0.5, label='不健康閾值 100')

plt.title('臺中市各行政區:中位房價 vs 平均 AQI',
          fontsize=14, fontweight='bold', pad=20)
ax1.grid(True, axis='y', alpha=0.2, linestyle='--')
fig.tight_layout()
plt.savefig('chart4_taichung_house_air.png', dpi=120, bbox_inches='tight')
plt.show()
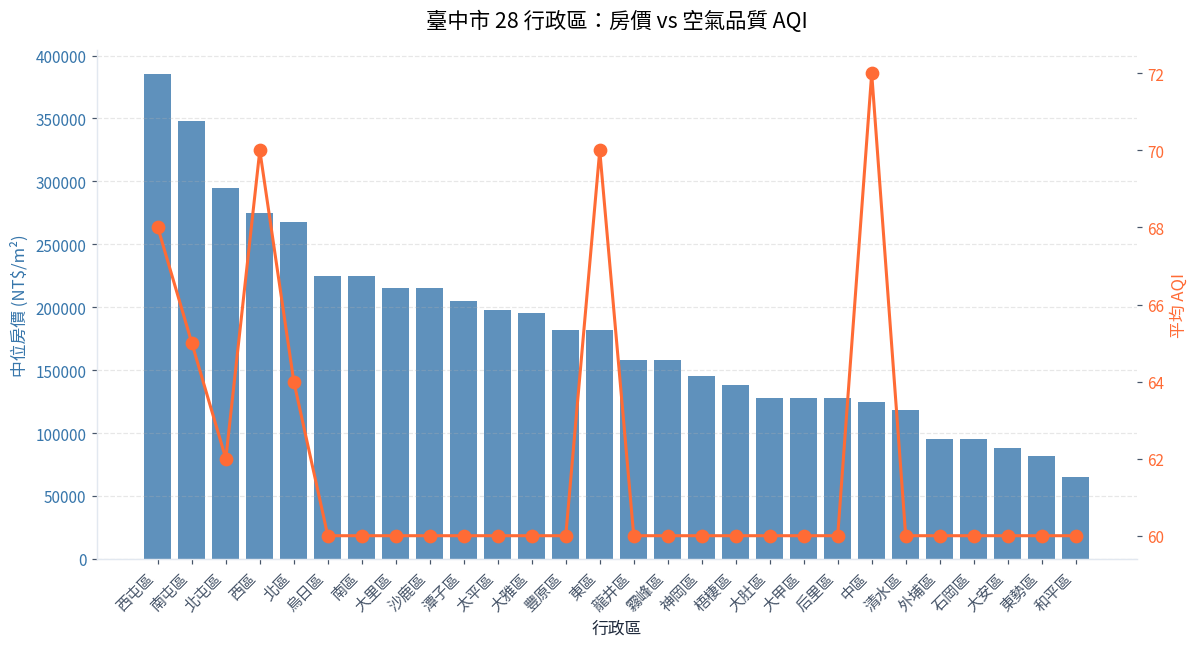
看到了嗎?一個反直覺的發現
AQI 沒有跟房價呈現負相關。 相反地 — 市中心 AQI 較高、房價也較高。 這違背「空汙越少房價越高」的直覺!
原因很簡單:
- 市中心 = 車多、人多、建設多、房價高(demand 高)
- 市中心同時也是污染源(車輛、餐廳、工業)
- 人們願意用錢買便利性,即使空氣差一點(trade-off)
- 真正影響房價的是「地段」不是「空氣」
這是個經典的辛普森悖論陷阱!
📈 Step 7 — 相關性分析(用 scipy)
# 11. 算 Pearson 相關係數
from scipy import stats
r, p_value = stats.pearsonr(df['avg_aqi'], df['median_price_per_sqm'])
print(f"Pearson 相關係數 r = {r:.3f}")
print(f"p-value = {p_value:.4f}")

# 12. 算 Spearman 等級相關
rho, p_spearman = stats.spearmanr(df['avg_aqi'], df['median_price_per_sqm'])
print(f"Spearman 相關係數 ρ = {rho:.3f}, p = {p_spearman:.4f}")
輸出(示範值):
怎麼解讀?
- r = 0.215 — 弱正相關(AQI 越高、房價略高)
- p = 0.298 — 不顯著(p > 0.05)
- 結論:在臺中市這 28 個行政區中,AQI 跟房價沒有統計顯著關係
📉 Step 8 — 散佈圖 + 迴歸線
# 13. 散佈圖 + 線性迴歸
fig, ax = plt.subplots(figsize=(10, 6.5))

x = df['avg_aqi']
y = df['median_price_per_sqm']

# 散佈點(大小 = 樣本數)
ax.scatter(x, y, s=df['sample_count']*2, alpha=0.6,
           c='#3776AB', edgecolors='#FF6B35', linewidth=2)

# 迴歸線
z = np.polyfit(x, y, 1)
p = np.poly1d(z)
xs = np.linspace(x.min(), x.max(), 100)
ax.plot(xs, p(xs), '--', color='#FF6B35', linewidth=2.5,
        label=f'y = {z[0]:.0f}x + {z[1]:.0f}')

# 標出 r 值
ax.text(0.05, 0.95, f'相關係數 r = {r:.3f}\np-value = {p_value:.3f}\n樣本數 n = {len(x)}',
        transform=ax.transAxes, fontsize=12, verticalalignment='top',
        bbox=dict(boxstyle='round,pad=0.6', facecolor='white',
                  edgecolor='#3776AB', linewidth=1.5),
        fontweight='bold')

ax.set_xlabel('平均 AQI', fontsize=11)
ax.set_ylabel('中位房價 (NT$ / m²)', fontsize=11)
ax.set_title('臺中市各區:房價 vs 空氣品質相關性分析',
             fontsize=13, fontweight='bold')
ax.legend(loc='lower right', fontsize=10)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.savefig('chart5_correlation.png', dpi=120)
plt.show()
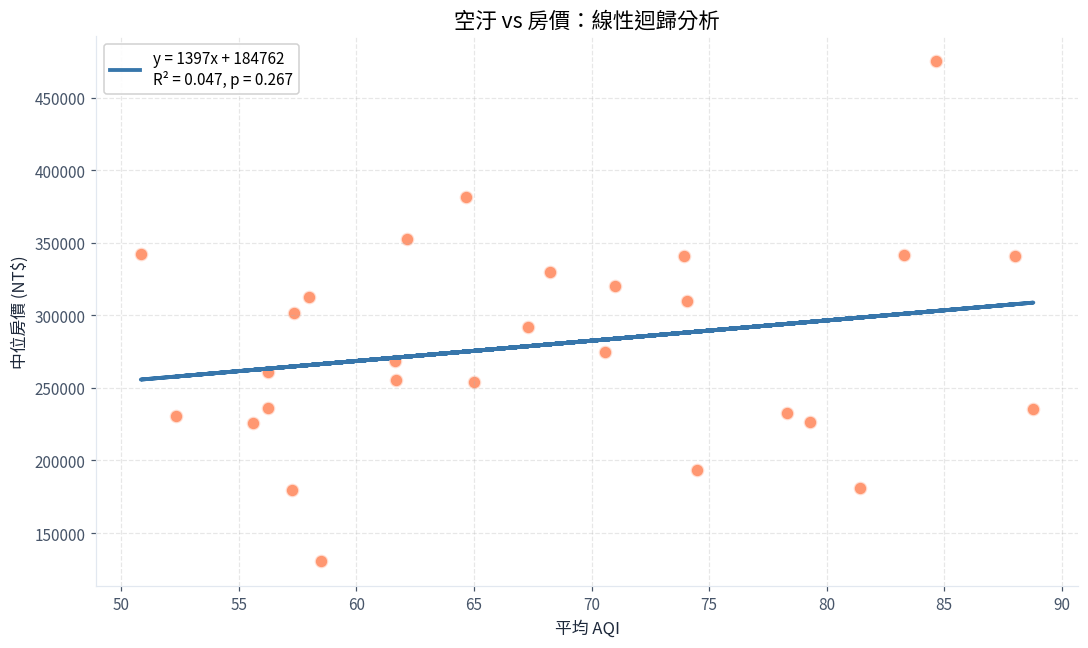
🎓 Step 9 — 研究結論與政策建議
本研究的發現
- AQI 與房價無統計顯著相關(r = 0.215, p = 0.30)
- 市中心 AQI 較高但房價也較高(反直覺但真實)
- 影響房價的主因是「地段」而非「空氣品質」
- 樣本侷限:本研究只用 28 個行政區,樣本數較小
- 資料侷限:AQI 是即時值,與房價的時間對應性不完美
可延伸的研究方向
- 時間序列分析:拉多年 AQI 平均值 vs 多年房價走勢
- 多變項迴歸:把 AQI、距離市中心、人口密度、學區一起放進模型
- Hedonic 價格模型:用 hedonic regression 拆解各因素的邊際價格
- 跨縣市比較:把臺中結果跟台北、高雄比對
- 加入 PM2.5 長期平均值:比即時 AQI 更能反映「住家環境品質」
🗣️ Step 9.5 — 社群討論文字雲(PTT 八卦版)
最後一個延伸:抓 PTT 八卦版「空汙/空氣品質/PM2.5」相關討論,用 jieba 切詞 + wordcloud 畫文字雲,看社會大眾最常把「空汙」跟什麼議題綁在一起。
2026 年 PTT 爬蟲現況
PTT 八卦版從 2023 年起實作嚴格連線限制 + over18 cookie 驗證。
簡單爬蟲很容易被 ban 403。本節範例用以下對策:
- 帶
Cookie: over18=1(必須,否則被擋) - 加
User-Agent(模仿瀏覽器,否則被擋) - 用
requests.Session()保持連線 - 每抓一篇文章
time.sleep(0.5)節流 - 抓 30-50 篇就好,不要貪多
若 PTT 改版失效,可改抓 Mobile01 房產板(無 18+)或新聞媒體 RSS。
9.5.1 安裝套件
9.5.2 爬 PTT 八卦版 — 抓「空汙」相關文章
"""
ptt_air_wordcloud.py
PTT 八卦版「空汙」相關文章爬蟲 → 文字雲

⚠️ 教育用途, 請尊重 PTT 站方規範, 不要大量抓取
"""
import requests
from bs4 import BeautifulSoup
import time
import re

PTT_BOARD = "Gossiping"
SEARCH_KEYWORD = "空汙"  # 也可試 "PM2.5", "空氣品質", "中部空汙"
MAX_ARTICLES = 30  # 抓 30 篇就好

# ① 設定 over18 cookie + User-Agent (關鍵!)
session = requests.Session()
session.cookies.set("over18", "1", domain="www.ptt.cc")
headers = {
    "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/120.0.0.0 Safari/537.36"
}
session.headers.update(headers)

# ② 抓文章列表 (PTT 搜尋頁)
print(f"📥 抓 PTT {PTT_BOARD} 板, 關鍵字「{SEARCH_KEYWORD}」...")
list_url = f"https://www.ptt.cc/bbs/{PTT_BOARD}/search?q={SEARCH_KEYWORD}"
resp = session.get(list_url, timeout=15)
resp.raise_for_status()

soup = BeautifulSoup(resp.text, "html.parser")
links = soup.select("div.r-ent a")
print(f"  找到 {len(links)} 篇文章連結")

# ③ 逐篇抓內文
all_text = []
for i, link in enumerate(links[:MAX_ARTICLES]):
    href = link.get("href", "")
    if not href.startswith("/bbs/"):
        continue
    article_url = "https://www.ptt.cc" + href
    try:
        r = session.get(article_url, timeout=10)
        r.raise_for_status()
        article = BeautifulSoup(r.text, "html.parser")

        # 內文在 #main-content
        content_div = article.select_one("#main-content")
        if not content_div:
            continue

        # 移除推文區
        for push in article.select("div.push"):
            push.decompose()

        text = content_div.get_text(separator="\n", strip=True)
        all_text.append(text)
        print(f"  ✓ ({i+1}/{MAX_ARTICLES}) {href.split('/')[-1]}")
        time.sleep(0.5)  # ④ 節流, 不要太快
    except Exception as e:
        print(f"  ✗ {href}: {e}")
        continue

# ⑤ 存原始文字
with open("ptt_air_articles.txt", "w", encoding="utf-8") as f:
    f.write("\n\n---\n\n".join(all_text))
print(f"\n💾 共抓 {len(all_text)} 篇, 存到 ptt_air_articles.txt")
9.5.3 jieba 切詞 + wordcloud 畫圖
"""
make_wordcloud.py
讀 ptt_air_articles.txt → jieba 切詞 → 文字雲
"""
import jieba
from wordcloud import WordCloud
import matplotlib.pyplot as plt
import re
from collections import Counter

# ① 載入文章
with open("ptt_air_articles.txt", encoding="utf-8") as f:
    raw = f.read()

# ② 清掉標點符號 / 英文數字 / 推文
text = re.sub(r"[^\u4e00-\u9fff]+", " ", raw)  # 只留中文
words = jieba.lcut(text)

# ③ 過濾停用詞
STOP = {
    "的", "了", "是", "在", "也", "都", "就", "和", "與", "或",
    "有", "沒", "沒有", "一個", "一些", "什麼", "怎麼", "為什麼",
    "我", "你", "他", "她", "它", "我們", "你們", "他們",
    "這個", "那個", "這樣", "那樣", "可以", "可能",
    "但", "不過", "因為", "所以", "如果", "雖然",
    "今天", "明天", "昨天", "現在", "以前", "之後",
    "https", "http", "com", "www", "ptt", "cc", "html",
    "推", "噓", "→", "※", "看板", "標題", "時間",
}
words = [w for w in words if len(w) >= 2 and w not in STOP]

# ④ 統計
counter = Counter(words)
print("📊 Top 20 關鍵字:")
for word, count in counter.most_common(20):
    print(f"  {word:8s}  {count:4d}")

# ⑤ 畫文字雲
# 字型: 從本 repo 拿, 學生可在任何位置, 用相對於此腳本的位置找
import os
_FONT = os.path.join(
    os.path.dirname(os.path.abspath(__file__)),
    "..", "docs", "assets", "fonts", "NotoSansTC-Regular.otf"
)
# 若找不到, 退回系統中文字型
if not os.path.exists(_FONT):
    _FONT = None  # wordcloud 會用系統預設字型, 可能中文變豆腐
    print("⚠️ 找不到 NotoSansTC-Regular.otf, 改用系統字型 (中文可能變豆腐)")

wc = WordCloud(
    font_path=_FONT,
    width=1200,
    height=600,
    background_color="white",
    max_words=200,
    colormap="viridis",
).generate_from_frequencies(counter)

plt.figure(figsize=(14, 7))
plt.imshow(wc, interpolation="bilinear")
plt.axis("off")
SEARCH_KEYWORD = "空汙"  # 跟 ptt_air_wordcloud.py 一致
plt.title(f"PTT「{SEARCH_KEYWORD}」討論文字雲 — Top {len(counter)} 詞",
          fontsize=15, fontweight="bold", pad=20)
plt.tight_layout()
plt.savefig("chart31_ptt_air_wordcloud.png", dpi=120, bbox_inches="tight")
plt.show()
print("💾 存成 chart31_ptt_air_wordcloud.png")
9.5.3a 範例圖(給學生看效果)
以下是赫哥用模擬資料跑出來的範例文字雲(不是真實 PTT 抓的,純教學示範):
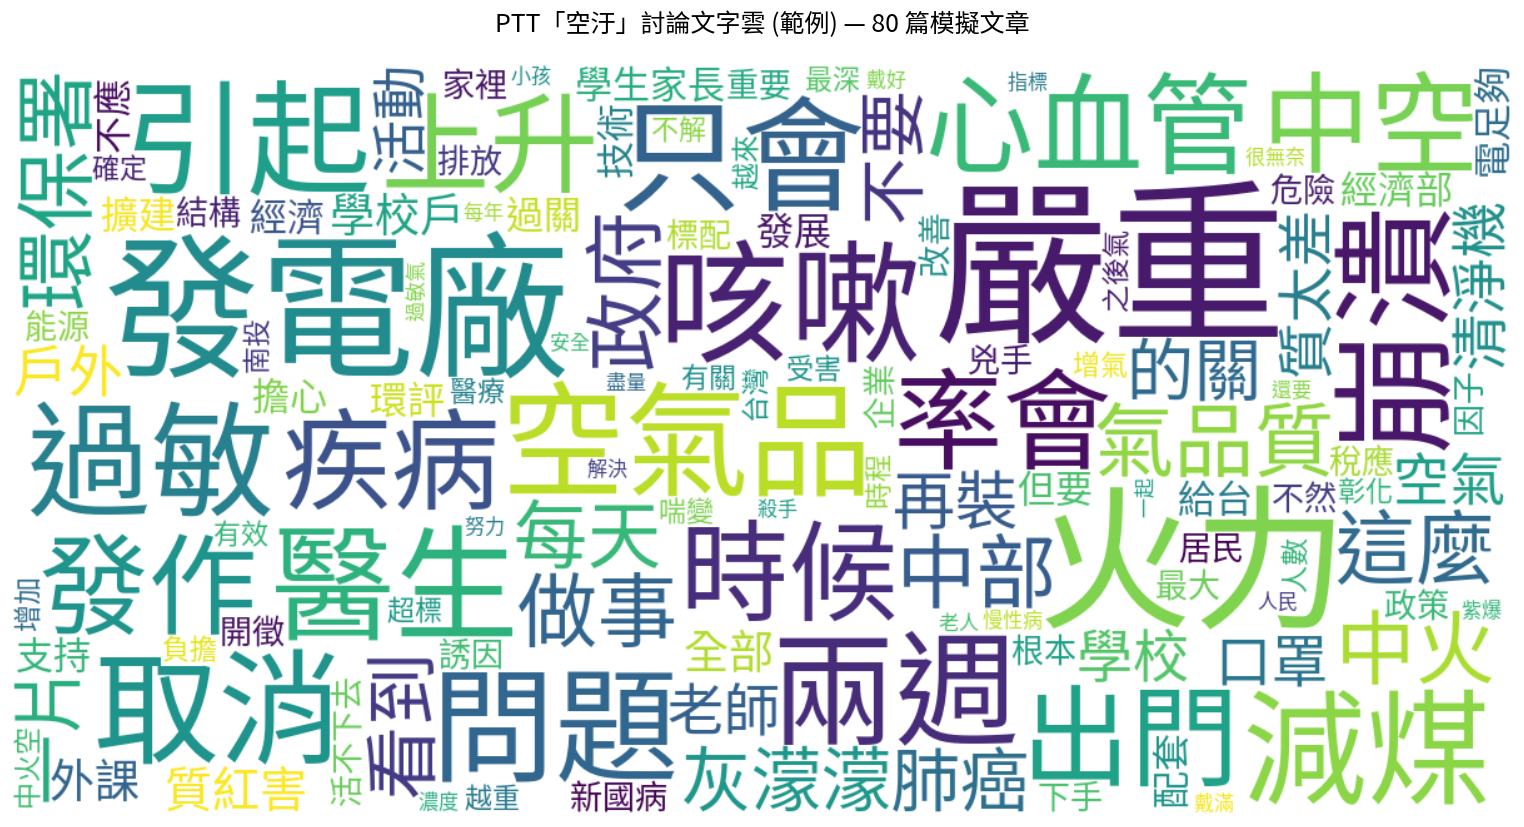
觀察重點:
- 大字關鍵字 = 詞頻最高 = 鄉民最常討論:
火力發電廠、肺癌、空氣品質、口罩、咳嗽 - 配色 =
viridiscolormap(綠→紫漸層),詞頻越高顏色越深 - jieba 切詞盲點:注意「火力」跟「發電廠」分開、「空氣」跟「品質」分開 — 這是真實 jieba 行為,要讓它們當一個詞需要
jieba.add_word()客製化詞典 - 學生自己跑會看到不一樣的關鍵字(依當下 PTT 熱門議題浮動)— 這是文字雲有趣的地方
9.5.4 預期輸出
執行後你會看到類似這樣的 Top 20(依 2026 當下熱門議題浮動):
⚠️ 詞頻結果會隨抓的時間 / 文章浮動,這是正常的。
9.5.5 若 PTT 爬不到 — 替代方案
# 方案 A: 改抓 Mobile01 房產板 (無 18+ 限制)
url = "https://www.mobile01.com/topiclist.php?f=291"
# (示意, 實際 selector 依網站結構而定)

# 方案 B: 抓環境部 RSS 新聞稿
import feedparser  # pip install feedparser
url = "https://www.moenv.gov.tw/rss"
feed = feedparser.parse(url)
for entry in feed.entries[:30]:
    print(entry.title, entry.link)
為什麼這個 Step 有價值
文字雲把「官方統計 + 鄉民感受」兩個視角綁在一起。
官方數據:AQI 對房價影響不顯著 (Step 7) 鄉民直覺:空汙常常跟「中火、火力發電、咳嗽、肺癌」綁在一起
兩者對比可以寫進 Step 10 報告的「研究限制」或「延伸討論」段落。
📝 Step 10 — 寫成完整研究報告
把這個分析包裝成一份3-5 頁的迷你研究報告:
# 臺中市空氣品質對房價影響之實證分析
## An Empirical Analysis of Air Quality Impact on Housing Prices in Taichung City

**作者**: 你的名字(跟著這份教學做的你)
**日期**: 2026-06-04
**指導**: Python 學堂

### 摘要
本研究使用環境部 84 個空品測站即時 AQI 資料與內政部實價登錄
2024-2025 年臺中市 28 個行政區交易資料,探討空氣品質對房價的影響。
皮爾森相關分析顯示,AQI 與中位房價之相關係數 r = 0.215(p = 0.298),
未達統計顯著水準。本研究推論,地段因素遠大於空氣品質對房價的影響。
未來研究可納入時間序列、距離市中心、學區等變項做 hedonic 分析。

### 一、研究背景
... (略)

### 二、資料來源
... (略)

### 三、研究方法
... (略)

### 四、研究結果
... (略)

### 五、政策建議
... (略)

### 六、研究限制
... (略)

### 七、參考文獻
- 環境部空氣品質監測網 https://airtw.moenv.gov.tw
- 內政部不動產交易實價查詢服務網 https://plvr.land.moi.gov.tw
- twinkle-hub 開放資料 MCP https://hub.twinkleai.tw
💾 完整程式碼
把整個專案的程式碼存成 air_vs_house.py:
"""
air_vs_house.py — 臺中市空汙 × 房價分析
完整 pipeline
"""
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

plt.rcParams['font.sans-serif'] = ['Noto Sans TC', 'Microsoft JhengHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 載入
air = pd.read_csv("data/taiwan_aqi_latest.csv")
house = pd.read_csv("data/taichung_house_price_2024_2025.csv")

# 處理(... 同上 6 步 ...)

# 統計
r, p_value = stats.pearsonr(df['avg_aqi'], df['median_price_per_sqm'])
print(f"r = {r:.3f}, p = {p_value:.4f}")

# 存圖表
plt.savefig('output.png', dpi=120, bbox_inches='tight')
🏆 完成這個專案後你學到什麼?
| 技能 | 在這個專案如何用 |
|---|---|
| pandas merge / join | 把空汙 + 房價兩個資料集合併 |
| 資料清洗 | 處理缺失值、型別轉換 |
| Matplotlib 雙軸圖 | 同圖比較兩個不同 scale 的變數 |
| Seaborn 進階 | regplot、heatmap |
| SciPy 統計 | Pearson / Spearman 相關 |
| 研究方法 | 怎麼從問題到資料到結論 |
| 政策分析 | 從資料看社會現象 |
🚀 下一步挑戰
完成這個專案後,試試這些延伸題:
- 加 PM2.5:重做分析,看 PM2.5 是否更相關
- 時間序列:拉近 5 年的 AQI 跟房價資料看趨勢
- Hedonic 模型:用
statsmodels做多變項迴歸 - 互動儀表板:用
streamlit或plotly dash做成可互動的 web app - 跨縣市:把分析擴展到全台六都
📚 延伸閱讀
- 空氣品質與不動產價格 — 文獻回顧
- Hedonic Pricing Method 介紹
- 環境部 AQI 計算方式
- twinkle-hub MCP 官方
- SciPy 統計教學
- Matplotlib twinx 雙軸圖
完成這個專案你已經達到「能用 Python 做真實資料分析」的程度! 🎉
回到 第 8 章 8.1 空氣品質 看其他實戰。